R-Code
dat <- data.frame(
  Person = 1:4,
  IQ = c(100, 104, 108, NA)
)

dat
Person IQ
1 1 100
2 2 104
3 3 108
4 4 NA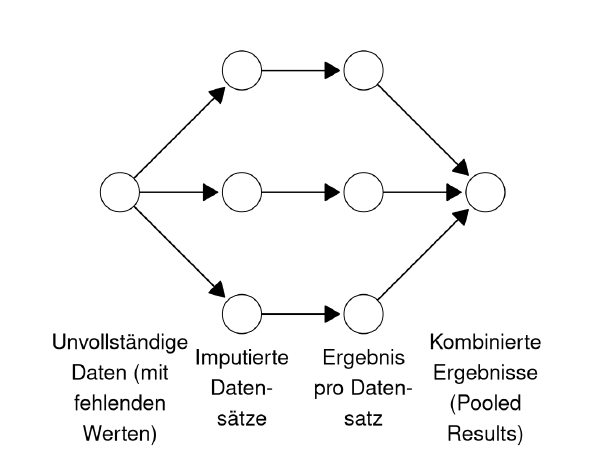
Bei multipler Imputation wird ein fehlender Wert nicht nur einmal ersetzt. Stattdessen werden mehrere plausible vollständige Datensätze erzeugt. Jeder dieser Datensätze wird zunächst separat analysiert. Anschließend werden die Parameterschätzungen und ihre Unsicherheiten kombiniert. Dieser letzte Schritt wird als Pooling bezeichnet. Schematisch zeigt Figure 1 den Ablauf.
Das folgende Beispiel ist absichtlich sehr klein und stark vereinfacht. Es kann aber zeigen, was die Grundidee der multiplen Imputation ist.
Wir untersuchen den IQ von vier Personen und möchten prüfen, ob der mittlere IQ vom Referenzwert 100 abweicht (\(H_0:\mu=100\)). Von vier Personen liegen nur drei IQ-Werte vor.
dat <- data.frame(
Person = 1:4,
IQ = c(100, 104, 108, NA)
)
dat Person IQ
1 1 100
2 2 104
3 3 108
4 4 NABei multipler Imputation werden fehlende Werte mehrfach durch plausible Werte ersetzt. Hier soll es nicht um den konkreten Imputationsalgorithmus gehen. Für unser Beispiel nehmen wir an, dass ein valider Imputationsalgorithmus für drei imputierte Datensätze die Werte \({102;104;106}\) erzeugt.
| Person | Ausgangsdaten | Imputation 1 | Imputation 2 | Imputation 3 |
|---|---|---|---|---|
| 1 | 100 | 100 | 100 | 100 |
| 2 | 104 | 104 | 104 | 104 |
| 3 | 108 | 108 | 108 | 108 |
| 4 | NA | 102 | 104 | 106 |
Entscheidend ist nun, dass die drei imputierten Datensätze nicht zu einem einzigen Datensatz zusammengeführt werden. Stattdessen wird jeder Datensatz zunächst separat mit demselben statistischen Verfahren analysiert.
Jeder der drei imputierten Datensätze wird nun separat analysiert. Für jeden Datensatz schätzen wir den Mittelwert, die Populationsvarianz und den Standardfehler des Mittelwerts. Für den geschätzten Standardfehler gilt \(\widehat{\sigma}_{\bar{x},j}=\sqrt{\widehat{\sigma}^2_j/n}\).
# Imputierter Datensatz 1
x1 <- dat$IQ
x1[is.na(x1)] <- imp[1]

xbar1 <- mean(x1)
sigma2_1 <- var(x1)
SE1 <- sqrt(sigma2_1 / length(x1))


# Imputierter Datensatz 2
x2 <- dat$IQ
x2[is.na(x2)] <- imp[2]

xbar2 <- mean(x2)
sigma2_2 <- var(x2)
SE2 <- sqrt(sigma2_2 / length(x2))


# Imputierter Datensatz 3
x3 <- dat$IQ
x3[is.na(x3)] <- imp[3]

xbar3 <- mean(x3)
sigma2_3 <- var(x3)
SE3 <- sqrt(sigma2_3 / length(x3))| Imputation | imputierter IQ | \(\bar{x}_j\) | \(\widehat{\sigma}^2_j\) | \(\widehat{\sigma}_{\bar{x},j}\) |
|---|---|---|---|---|
| 1 | 102 | 103.5 | 11.67 | 1.71 |
| 2 | 104 | 104.0 | 10.67 | 1.63 |
| 3 | 106 | 104.5 | 11.67 | 1.71 |
Jeder imputierte Datensatz liefert damit einen eigenen Schätzwert für den Mittelwert und eine eigene Schätzunsicherheit. Diese Ergebnisse bilden die Grundlage für das anschließende Pooling. # 3. Gepoolter Punktschätzer
Der gepoolte Punktschätzer ist der Mittelwert aus den imputierten Datensätzen: \(\bar{x}_{pool}=\frac{103.5+104+104.5}{3}=104\)
xbar <- c(103.5, 104, 104.5)
xbar_pool <- mean(xbar)
Bis hierhin ist Pooling lediglich eine Mittelung. Für die Berechnung der Unsicherheit müssen dagegen zwei Varianzkomponenten berücksichtigt werden. Schematisch gilt:
\(\text{Gesamtunsicherheit}=\text{Within-Imputation-Varianz}+\text{Between-Imputation-Varianz}\)
Die mittlere Within-Imputation-Varianz lautet \(\bar{U}=\frac{1}{m}\sum_{j=1}^{m}\widehat{\sigma}_{\bar{x},j}^{\,2}\approx2.83\).
U_bar <- mean(c(SE1^2, SE2^2, SE3^2))Die Between-Imputation-Varianz beschreibt die Streuung der Schätzwerte um den gepoolten Mittelwert: \(B=\frac{1}{m-1}\sum_{j=1}^{m}(\bar{x}_j-\bar{x}_{pool})^2=\frac{1}{3-1}\left[(103.5-104)^2+(104-104)^2+(104.5-104)^2\right]=0.25\).
B <- var(xbar)Die Gesamtvarianz (Gesamtunsicherheit) kombiniert die Within- und Between-Imputation-Varianz. Nach den Pooling-Regeln für multiple Imputation (Rubin, 1987, zitiert nach van Buuren, 2018) gilt:
\(T=\bar{U}+\left(1+\frac{1}{m}\right)B=2.833+\left(1+\frac{1}{3}\right)\cdot0.25=3.17\)
Der gepoolte Standardfehler ergibt sich anschließend als:
\(\widehat{\sigma}_{\bar{x},pool}=\sqrt{T}\)
m <- length(xbar)

T <- U_bar + (1 + 1/m) * B
sigma_xbar_pool <- sqrt(T)
Damit erhalten wir \(T\approx3.17\) und einen gepoolten Standardfehler von \(\widehat{\sigma}_{\bar{x},pool}\approx1.78\).
Der gepoolte Standardfehler von \(\widehat{\sigma}_{\bar{x},pool}=1.78\) IQ-Punkten beschreibt die Unsicherheit des geschätzten Mittelwerts \(\bar{x}_{pool}=104\). Bei wiederholter Stichprobenziehung und Imputation würde der geschätzte Mittelwert typischerweise um etwa 1.78 IQ-Punkte um den wahren Populationsmittelwert streuen.
Für den Test gegen \(H_0:\mu=100\) verwenden wir den gepoolten Mittelwert und den gepoolten Standardfehler:
\(t_{pool}=\frac{\bar{x}_{pool}-100}{\widehat{\sigma}_{\bar{x},pool}}=\frac{104-100}{1.78}=2.25\)
Zum Vergleich ergeben sich ohne Imputation und bei einer einfachen Mittelwertimputation folgende t-Werte:
t_ohne <- t.test(c(100, 104, 108), mu = 100)$statistic
t_mittelwert <- t.test(c(100, 104, 108, 104), mu = 100)$statistic
t_pool <- (xbar_pool - 100) / sigma_xbar_pool
Die einfache Mittelwertimputation führt zum größten t-Wert, weil der imputierte Wert wie ein tatsächlich beobachteter Wert behandelt wird und die zusätzliche Unsicherheit der Imputation unberücksichtigt bleibt. Beim Pooling wird diese Unsicherheit dagegen in den Standardfehler einbezogen.
Ein tatsächlich vollständiger Datensatz mit vier beobachteten Personen hätte \(df_{com}=4-1=3\). Bei multipler Imputation können diese Freiheitsgrade jedoch nicht einfach übernommen werden, da der vierte Wert nicht tatsächlich beobachtet wurde.
Nach Barnard und Rubin (1999) werden die Freiheitsgrade unter Berücksichtigung der durch die Imputation entstehenden Unsicherheit angepasst:
\(\lambda=\frac{(1+1/m)B}{T}=\frac{(1+1/3)\cdot0.25}{3.17}=0.105\)
Damit ergeben sich:
\(df_{old}=\frac{m-1}{\lambda^2}=\frac{3-1}{0.105^2}=181.4\)
und
\(df_{obs}=\frac{df_{com}+1}{df_{com}+3}\cdot df_{com}\cdot(1-\lambda)=\frac{4}{6}\cdot3\cdot(1-0.105)=1.79\)
Die gepoolten Freiheitsgrade betragen damit:
\(df_{pool}=\frac{df_{old}\cdot df_{obs}}{df_{old}+df_{obs}}=\frac{181.4\cdot1.79}{181.4+1.79}=1.77\)
Ausführlich dargestellt sind diese Formeln bei Barnard und Rubin (1999) und sollen an dieser Stelle nicht weiter vertieft werden.
Für den gepoolten t-Wert von \(t_{pool}=2.25\) und die berechneten Freiheitsgrade von \(df_{pool}=1.77\) ergibt sich ein zweiseitiger p-Wert von \(p\approx.17\).
Zum Vergleich:
t.test(c(100, 104, 108), mu = 100)
    One Sample t-test

data:  c(100, 104, 108)
t = 1.7321, df = 2, p-value = 0.2254
alternative hypothesis: true mean is not equal to 100
95 percent confidence interval:
  94.06345 113.93655
sample estimates:
mean of x
104 t.test(c(100, 104, 108, 104), mu = 100)
    One Sample t-test

data:  c(100, 104, 108, 104)
t = 2.4495, df = 3, p-value = 0.09172
alternative hypothesis: true mean is not equal to 100
95 percent confidence interval:
  98.80309 109.19691
sample estimates:
mean of x
104 p_pool <- 2 * pt(-abs(t_pool), df = 1.77)Barnard, J. & Rubin, D. B. (1999). Small-sample degrees of freedom with multiple imputation. Biometrika, 86, 948–955.
Rubin, D. B. (1987). Multiple Imputation for Nonresponse in Surveys. Wiley.
van Buuren, S. & Groothuis-Oudshoorn, K. (2011). mice: Multivariate Imputation by Chained Equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
van Buuren, S. (2018). Flexible Imputation of Missing Data (2. Aufl.). Chapman & Hall/CRC.