# Bereits zentrierte und standardisierte Gewichte.
lambda <- rbind(
  A = c(1, 1, -2) / sqrt(2),
  B = c(-5, 7, -2) / sqrt(26)
)

colnames(lambda) <- c(
  "Auditiv", "Schriftlich", "Karte"
)

daten <- data.frame(
  Person = c("A1", "A2", "B1", "B2"),
  Pfad = c("A", "A", "B", "B"),
  Auditiv = c(0.7, 0.8, 0.3, 0.4),
  Schriftlich = c(0.7, 0.7, 0.7, 0.8),
  Karte = c(0.4, 0.5, 0.4, 0.6)
)

messwerte <- as.matrix(
  daten[, c("Auditiv", "Schriftlich", "Karte")]
)

personengewichte <- lambda[
  daten$Pfad,
  ,
  drop = FALSE
]

# Individuelle L-Werte.
daten$L <- rowSums(messwerte * personengewichte)

# Korrelation zwischen Gewichten und Messwerten
# über die drei Bedingungen jeder Person.
daten$r <- vapply(
  seq_len(nrow(daten)),
  function(i) {
    x <- messwerte[i, ]
    gewichte <- personengewichte[i, ]

    # Bei konstanten Messwerten ist r nicht definiert.
    if (sd(x) == 0) {
      return(NA_real_)
    }

    cor(gewichte, x)
  },
  numeric(1)
)
Lernziele in R
- Entwicklung pfadspezifischer Kontrastgewichte aus theoretischen Vorhersagen
- Zentrierung und Standardisierung der Kontrastgewichte
- Anwendung auf ein kleines Datenbeispiel mit individuellen \(L\)-Werten
- Vorteile und Grenzen pfadspezifischer Profilkontraste
Einführungsbeispiel: Einen Weg lernen
In einem hypothetischen Experiment untersuchen wir, wie gut Personen eine unbekannte Route anhand unterschiedlicher Darstellungen lernen. Jede Versuchsperson bearbeitet drei Bedingungen:
- Auditive Wegbeschreibung: Die Route wird als gesprochene Beschreibung präsentiert.
- Schriftliche Wegbeschreibung: Die Route wird als Text präsentiert.
- Kartendarstellung: Die Route wird auf einer Karte eingezeichnet.
Die Darstellungsform bildet damit einen Within-Faktor mit drei Stufen.
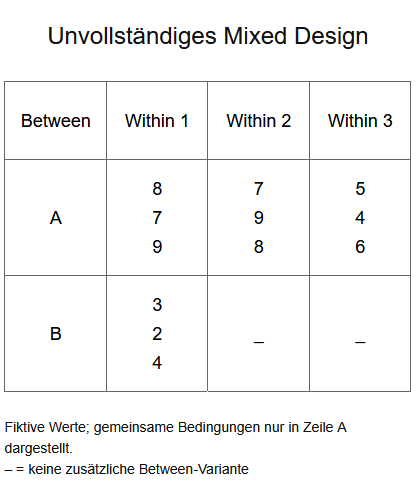
Nur bei der auditiven Wegbeschreibung variieren wir zusätzlich die Sprechgeschwindigkeit. Eine zufällig zugewiesene Gruppe hört die Beschreibung in normalem Tempo, die andere in deutlich erhöhtem Tempo. Der Wortlaut bleibt identisch.
| Pfad | Auditive Wegbeschreibung | Schriftliche Wegbeschreibung | Kartendarstellung |
|---|---|---|---|
| A | Normales Sprechtempo | Gleiche Darbietungsbedingungen | Gleiche Darbietungsbedingungen |
| B | Erhöhtes Sprechtempo | Gleiche Darbietungsbedingungen | Gleiche Darbietungsbedingungen |
Nach jeder Lernphase sollen die Personen die Route in einer virtuellen Umgebung rekonstruieren. Als abhängige Variable erfassen wir den Anteil korrekt gewählter Abzweigungen.
(Damit die Personen nicht dreimal dieselbe Route lernen, verwenden wir verschiedene Routen. Welche Route in welcher Darstellungsform gezeigt wird, wird über die Personen hinweg ausbalanciert. Auch die Reihenfolge der Darstellungsformen wird ausbalanciert.)
Die hypothetische Vorhersage
Für dieses Beispiel formulieren wir folgende Annahme: Eine Wegbeschreibung in normalem Sprechtempo und eine schriftliche Beschreibung führen zu gleichen Leistungen. Die Kartendarstellung führt zu einer geringeren Leistung. Bei erhöhtem Sprechtempo fällt die Leistung dagegen noch geringer aus als bei der Kartendarstellung.
| Pfad | Auditiv | Schriftlich | Karte |
|---|---|---|---|
| A | \(c\) | \(c\) | \(e\) |
| B | \(d\) | \(c\) | \(e\) |
Dabei gilt:
\[d<e<c.\]
Diese Rangfolge ist eine für das Beispiel angenommene Forschungshypothese. Die experimentelle Besonderheit besteht darin, dass die Sprechgeschwindigkeit ausschließlich innerhalb der auditiven Darstellungsform manipuliert wird. Zugleich liefert jede Person Messwerte für alle drei Darstellungsformen.
Rechenbeispiel
Aus der Hypothese leiten wir folgendes numerisches Rechenbeispiel ab.
| Pfad | Within 1 | Within 2 | Within 3 |
|---|---|---|---|
| A | 2 | 2 | -1 |
| B | -2 | 2 | -1 |
1. Within-Zentrierung
Die \(L\)-Werte erfassen die Passung des individuellen, empirischen Verlaufs entlang der numerischen Vorhersage. Dazu zentrieren wir zunächst die Vorhersagegewichte zeilenweise, also innerhalb jedes Pfads. Die so gebildeten Lambda-Gewichte summieren sich in jeder Zeile zu null. \[ x_{\mathrm{zentriert},ij}=x_{ij}-\bar x_{i\cdot}. \]
Dabei bezeichnet \(i\) den Pfad und \(j\) die Messung.
Die zentrierten Gewichte lauten:
| Pfad | Within 1 | Within 2 | Within 3 | Zeilensumme |
|---|---|---|---|---|
| A | \(1\) | \(1\) | \(-2\) | \(=0\) |
| B | \(-\frac53\) | \(\frac73\) | \(-\frac23\) | \(=0\) |
Allerdings verändern wir damit die Perspektive: Die gemeinsamen Ausgangswerte für Within 2 und Within 3 werden jetzt auf unterschiedliche Pfadmittelwerte bezogen. Ihre ursprüngliche Gleichheit zwischen den Pfaden wird nicht mehr berücksichtigt.
2. Die Gewichte auf eine gemeinsame Skala bringen
Um die \(L\)-Werte sinnvoll zu vergleichen, nutzen wir die \(z\)-Standardisierung.
\[ z_{ij} = \frac{x_{ij}-\bar x_{i\cdot}}{\sigma_i}. \]
Damit erhalten wir folgende standardisierte Gewichte (gerundet):
| Pfad | Within 1 | Within 2 | Within 3 |
|---|---|---|---|
| A | 0,707 | 0,707 | -1,414 |
| B | -0,981 | 1,373 | -0,392 |
Die beiden Gewichtssätze (Pfad A und Pfad B) beschreiben weiterhin unterschiedliche Profile. Für z.B. Within 2 ergeben sich deshalb unterschiedliche standardisierte Gewichte: 0,707 vs. 1,373.
Das bedeutet nicht, dass wir für Within 2 unterschiedliche absolute Messwerte vorhersagen. Die Gewichte beziehen sich auf die relative Position dieser Bedingung innerhalb des jeweiligen Profils. Für die Untersuchung der pfadspezifischen Passung mittels \(L\)-Werten ist das kein Widerspruch.
3. Individuelle \(L\)-Werte berechnen
Nun verknüpfen wir die standardisierten Gewichte mit den empirischen Messwerten jeder Person \(i\):
\[ L_i=\sum_{j=1}^{3}\lambda_j x_{ij}. \]
Dabei bezeichnet \(i\) die Person und \(j\) die Bedingung. Für \(\lambda_j\) setzen wir jeweils die bereits standardisierten Gewichte des Pfads ein, zu dem die Person gehört. Die \(L\)-Werte sind keine Korrelationen. Sie hängen auch von der Größe der individuellen Messwertunterschiede ab.
Ein kleines Datenbeispiel
Die folgenden Daten sind vollständig fiktiv. Jeweils zwei Personen gehören zu Pfad A und Pfad B.
Für jede Darstellungsform erfassen wir den Anteil korrekt gewählter Abzweigungen bei zehn Entscheidungen. Ein Wert von \(0{,}7\) entspricht sieben richtigen Entscheidungen.
R-Code: L-Werte und Profilkorrelationen berechnen
| Person | Pfad | Auditiv | Schriftlich | Karte | \(L_i\) | \(r_i(\lambda_{g(i),j}, X_{ij})\) |
|---|---|---|---|---|---|---|
| A1 | A | 0.7 | 0.7 | 0.4 | 0.424 | 1.000 |
| A2 | A | 0.8 | 0.7 | 0.5 | 0.354 | 0.945 |
| B1 | B | 0.3 | 0.7 | 0.4 | 0.510 | 1.000 |
| B2 | B | 0.4 | 0.8 | 0.6 | 0.471 | 0.961 |
Für eine Person in Pfad A gilt:
\[ L_{\mathrm{A1}} \approx 0{,}707\cdot0{,}7 + 0{,}707\cdot0{,}7 - 1{,}414\cdot0{,}4 = 0{,}4242. \]
Für eine Person in Pfad B gilt:
\[ L_{\mathrm{B1}} \approx -0{,}981\cdot0{,}3 + 1{,}373\cdot0{,}7 - 0{,}392\cdot0{,}4 = 0{,}5100. \]
Ein positiver \(L\)-Wert zeigt eine positive gerichtete Ausprägung entlang des vorhergesagten Profils. Ein negativer Wert zeigt eine Ausprägung in der entgegengesetzten Richtung.
4. Test des durchschnittlichen Profilkontrasts
Nachdem für jede Person mit den Gewichten ihres Pfads ein individueller \(L\)-Wert berechnet wurde, fassen wir alle \(L\)-Werte gemeinsam zusammen:
\[ \bar L=\frac{1}{N}\sum_{i=1}^{N}L_i. \]
Anschließend wird der durchschnittliche Profilkontrast wie die klassische Within-Kontrastanalyse getestet:
\[ H_0:\mu_L\leq0, \qquad H_1:\mu_L>0. \]
Dazu verwenden wir einen Einstichproben-\(t\)-Test:
\[ t = \frac{\bar L-L_0}{\hat{\sigma}_{\bar{L}}}, \qquad L_0=0, \qquad df=N-1, \]
R-Code: Einstichproben-t-Test
t.test(
  daten$L,
  mu = 0,
  alternative = "greater"
)
    One Sample t-test

data:  daten$L
t = 13.083, df = 3, p-value = 0.0004822
alternative hypothesis: true mean is greater than 0
95 percent confidence interval:
 0.3605267       Inf
sample estimates:
mean of x
0.4395995
5. Berechnung mit der Korrelation
Alternativ zu den \(L\)-Werten lässt sich für jede Person die Korrelation zwischen den Kontrastgewichten ihres Pfads und ihren empirischen Messwerten berechnen:
\[ r_i=\operatorname{cor}_j(\lambda_{g(i),j},x_{ij}). \]
Diese Profilkorrelation beschreibt die lineare Übereinstimmung zwischen Vorhersage und individuellem Verlauf. Ggf. sollte die Fisher-Z-Transformation vor der Mittelung genutzt werden.
6. Vorteile und Grenzen des Vorgehens
- Ein Kontrast bündelt die Profilvorhersagen in einem einzigen Test und kann bei passenden Gewichten eine höhere Teststärke als ein Omnibustest erreichen.
Aber:
- Ein signifikanter Gesamttest bestätigt nicht jeden Hypothesenteil: Ein passender Verlauf in A kann einen fehlenden oder gegenläufigen Verlauf in B ausgleichen.
- Unterschiede der absoluten Messwertniveaus zwischen A und B werden durch die zentrierten Profilkontraste nicht geprüft.
- Bei gleicher Gewichtung aller Personen beeinflusst der größere Pfad das Gesamtergebnis stärker. Ggf. sollten die mittleren \(L\)-Werte beider Pfade gleich gewichtet und die Standardfehler angepasst werden.
Literatur
Rosenthal, R., Rosnow, R. L., & Rubin, D. B. (2000). Contrasts and Effect Sizes in Behavioral Research: A Correlational Approach. Cambridge University Press.